
AWS Well-Architected Framework 是 AWS 整理的一套雲端架構設計準則,把「好的架構」拆成六個面向,稱為六大支柱(pillar)。每個支柱各有一組設計原則與檢查問題,用來評估一個工作負載(workload,指共同提供某項業務功能的一組資源與程式,例如一個電商網站)在這個面向有沒有風險。
SAA 的官方 Exam Guide 開頭就說明,這個考試驗證的是「依 AWS Well-Architected Framework 設計解決方案」的能力。四個考試 Domain 的名稱和其中四個支柱一一對應,題目問題句裡的限定詞,也幾乎都能對回某一個支柱。
六個支柱都是用來評估同一個工作負載,只是各自從不同的面向檢查:
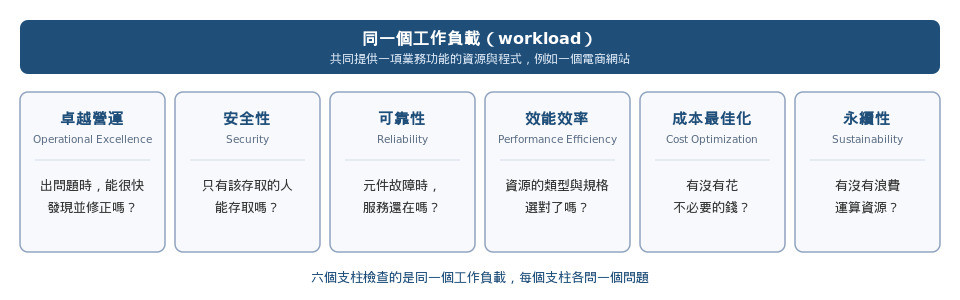
每個支柱的設計原則與對應的 AWS 做法:
| 支柱 | 關心的事 | 代表性的設計原則 | 對應的 AWS 做法 |
|---|---|---|---|
| Operational Excellence(卓越營運) | 系統怎麼部署、監控與變更,出問題時怎麼應對 | 以程式碼執行維運;頻繁、小幅、可回復的變更;預想故障並演練;從故障中學習 | CloudFormation 建立環境;Systems Manager Automation 執行維運步驟;CloudWatch 告警 |
| Security(安全性) | 保護資料、系統與帳號 | 建立強健的身分基礎(最小權限);保持可追溯性;每一層都套用安全控制;傳輸中與靜態資料都加密;讓人員遠離資料 | IAM role、SCP;CloudTrail、Config;Security Group 與 NACL;KMS、ACM |
| Reliability(可靠性) | 元件故障時自動復原,需求變動時仍能正常服務 | 自動從故障中復原;測試復原程序;水平擴展,避免單點故障;停止猜測容量;以自動化管理變更 | Multi-AZ;Auto Scaling 替換不健康的 instance;SQS 解耦;跨 Region 備援 |
| Performance Efficiency(效能效率) | 用合適的資源類型與規格,有效率地滿足效能需求 | 使用 AWS 受管的進階技術;在幾分鐘內部署到全球;使用 serverless 架構;多做實驗;依資料存取模式選擇技術 | CloudFront、Global Accelerator;Lambda、DynamoDB;read replica;快取 |
| Cost Optimization(成本最佳化) | 以最低的成本提供業務價值 | 建立雲端財務管理(例如把成本歸屬到各團隊並定期檢視);採用依用量付費的模式;衡量整體效率;不把錢花在和業務無關的繁重工作上(例如自己維護機房);分析並歸屬支出 | Auto Scaling、Spot、Savings Plans;S3 lifecycle;cost allocation tags、Cost Explorer |
| Sustainability(永續性) | 降低工作負載對環境的影響 | 了解自己的影響;提高資源使用率;採用效率更高的新硬體與軟體;使用受管服務 | 調整到合適的規格;Graviton instance;serverless 與受管服務 |
| 考試 Domain | 權重 | 對應的支柱 | 問題句常見的限定詞 |
|---|---|---|---|
| Domain 1:Design Secure Architectures | 30% | 安全性 | MOST secure、符合某項法規 |
| Domain 2:Design Resilient Architectures | 26% | 可靠性 | highest availability、without downtime、達成某個 RPO/RTO |
| Domain 3:Design High-Performing Architectures | 24% | 效能效率 | lowest latency、MOST performant |
| Domain 4:Design Cost-Optimized Architectures | 20% | 成本最佳化 | MOST cost-effective |
另外兩個支柱沒有獨立的 Domain,但出現的方式不同:
支柱之間經常互相衝突:Multi-AZ 提高可靠性,但資料庫費用大約加倍;把資料多複製一份到另一個 Region,可靠性更高,成本也更高。題目的四個選項通常都「能運作」,差別在於各自偏向哪一個支柱,問題句的限定詞決定由哪一個支柱勝出。
同樣是「一個 RDS 資料庫」,限定詞不同,正解就不同:
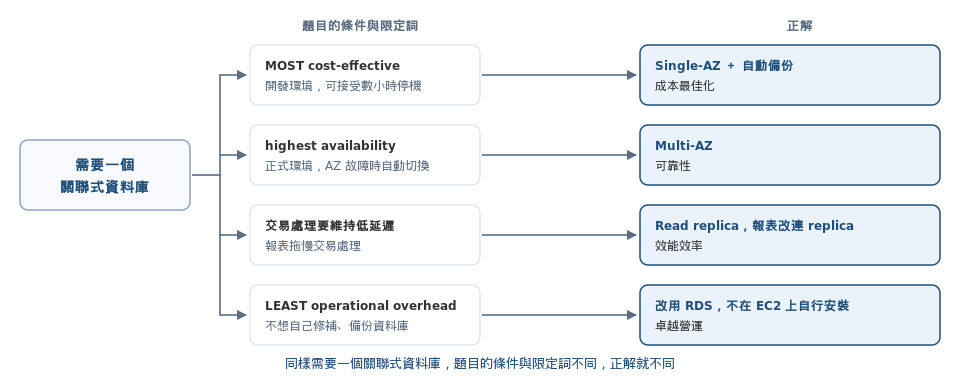
| 題目的需求與限定詞 | 偏向的支柱 | 選擇 |
|---|---|---|
| 開發環境,可以接受數小時的停機,MOST cost-effective | 成本最佳化 | Single-AZ,搭配自動備份 |
| 正式環境,AZ 故障時自動切換,highest availability | 可靠性 | Multi-AZ |
| 報表查詢拖慢交易處理,交易處理要維持低延遲 | 效能效率 | Read replica,報表改連 replica |
| 不想自己管理資料庫的修補與備份,LEAST operational overhead | 卓越營運 | 從 EC2 上自行安裝的資料庫改成 RDS |
作答時先讀問題句的限定詞,確定要用哪一個支柱判斷,再回頭讀情境,找出會讓其他選項出局的條件。下一節把這個過程拆開來看。
用途:把「知道各支柱在意什麼」轉成實際作答的方法。
SAA 的錯誤選項大致有三種:
前兩種可以直接刪掉,第三種要比較,所以判斷分成兩步:
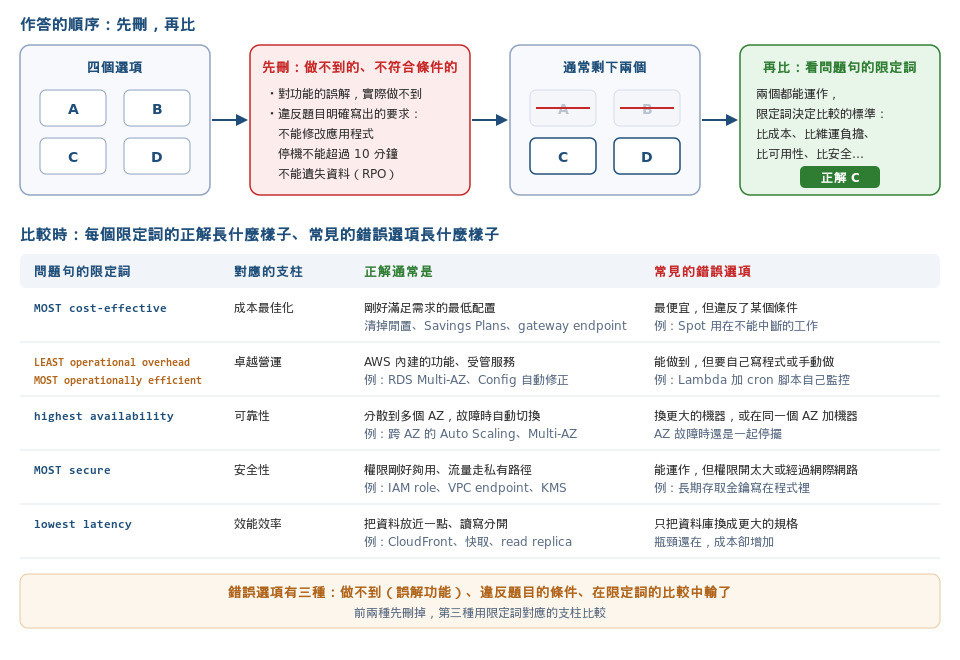
每個限定詞的正解與錯誤選項,各有常見的樣子:
| 限定詞 | 正解通常是 | 常見的錯誤選項 |
|---|---|---|
| MOST cost-effective | 剛好滿足需求的最低配置 | 最便宜,但違反了某個條件,例如 Spot 用在不能中斷的工作 |
| LEAST operational overhead、MOST operationally efficient | AWS 內建的功能、受管服務 | 能做到,但要自己寫程式監控或手動操作 |
| highest availability | 分散到多個 AZ,故障時自動切換 | 換更大的機器,或在同一個 AZ 加機器 |
| MOST secure | 權限剛好夠用、流量走私有路徑 | 能運作,但權限開太大或經過網際網路 |
| lowest latency | 把資料放近一點、讀寫分開 | 只把資料庫換成更大的規格 |
某公司在 EC2 上執行訂單 API,資料庫是 Single-AZ 的 Amazon RDS for MySQL。公司要求資料庫所在的 AZ 故障時能自動恢復,而且不能遺失任何已經確認的訂單。
哪一個方案的維運負擔最低(LEAST operational overhead)?
A. 在另一個 AZ 建立 read replica,以 Lambda 監控主要資料庫,故障時自動把 replica 升級為主要資料庫
B. 把資料庫換成更大的 instance 類型並啟用自動備份,故障時從最新的備份還原
C. 把資料庫改為 Multi-AZ 部署
D. 在兩個 AZ 的 EC2 上自行安裝 MySQL 並設定同步複寫,再撰寫腳本在故障時切換
先刪:題目有兩個要求,「AZ 故障時自動恢復」與「不能遺失已經確認的訂單」。A 的 read replica 是非同步複製:主要資料庫確認一筆訂單後,replica 可能還沒收到,這時發生故障,最後幾筆訂單就會遺失,違反第二個要求。B 的資料庫仍在單一 AZ,從備份還原要人工操作,而且會遺失最後一次備份之後的資料,兩個要求都不符合。剩下 C 和 D。
再比:C 的 Multi-AZ 以同步方式把每筆寫入複製到另一個 AZ 的 standby,D 也設定了同步複寫,兩者都能在故障時自動切換且不遺失資料。限定詞是 LEAST operational overhead,對應卓越營運:C 的複製、偵測與切換都由 RDS 處理,連線的 endpoint 也不變;D 要自己維護兩台 EC2 上的 MySQL、複寫設定與切換腳本。正解是 C。
這題的錯誤選項各自代表一種常見的樣子:A 是「看起來能做到,但不符合題目的條件」,B 是「換更大的機器」,D 是「能做到,但要自己維護」。
用途:依六大支柱審查一個工作負載的設計與維運做法,找出風險並追蹤改善。
AWS Well-Architected Tool 是主控台中的免費服務,用來依六大支柱審查一個工作負載:
除了六大支柱的通用問題,還可以套用 lens:針對特定類型工作負載的額外檢查問題,例如 Serverless Lens、SaaS Lens。每次審查完可以存成 milestone,記錄當時的狀態,之後比較改善的進度。
題目描述「依 AWS 最佳實務定期審查架構、追蹤改善項目」時,對應的就是 Well-Architected Tool。
用途:自動找出帳號中不符合最佳實務的資源設定,例如閒置的資源、過度開放的 Security Group。
AWS Trusted Advisor 自動掃描帳號中實際存在的資源,找出不符合最佳實務的設定,檢查項目分成六類,和支柱大致對應:
| 類別 | 檢查的例子 | 對應的支柱 |
|---|---|---|
| Cost optimization | 閒置的 load balancer、使用率低的 EC2、未關聯的 Elastic IP | 成本最佳化 |
| Performance | 使用率過高的 EC2、CloudFront 設定 | 效能效率 |
| Security | Security Group 對所有 IP 開放特定 port、root user 沒有 MFA、公開的 EBS snapshot | 安全性 |
| Fault tolerance | 沒有跨 AZ 的資源、沒有啟用備份的 RDS、EBS 沒有近期的 snapshot | 可靠性 |
| Service limits | 用量接近服務配額(service quota)上限 | 可靠性 |
| Operational excellence | 維運相關的設定,例如 API Gateway 沒有啟用執行日誌 | 卓越營運 |
可以使用的檢查項目取決於 AWS Support 方案。Basic 方案只有 service limits 類別的全部檢查,以及 security、fault tolerance 類別中的部分檢查;Business Support+ 以上的方案才能使用全部檢查、以 AWS Support API 程式化取得結果,並以組織檢視彙整 AWS Organizations 中所有帳號的結果。(舊的 Developer 與 Business 方案自 2025 年 12 月起不再開放新訂閱,2027 年 1 月 1 日停止;較舊的教材與考題會寫成「Business 以上」。)
Well-Architected Tool 和 Trusted Advisor 的差別在於檢查的對象:前者由人回答問卷,檢查的是做法;後者自動掃描,檢查的是實際存在的資源。
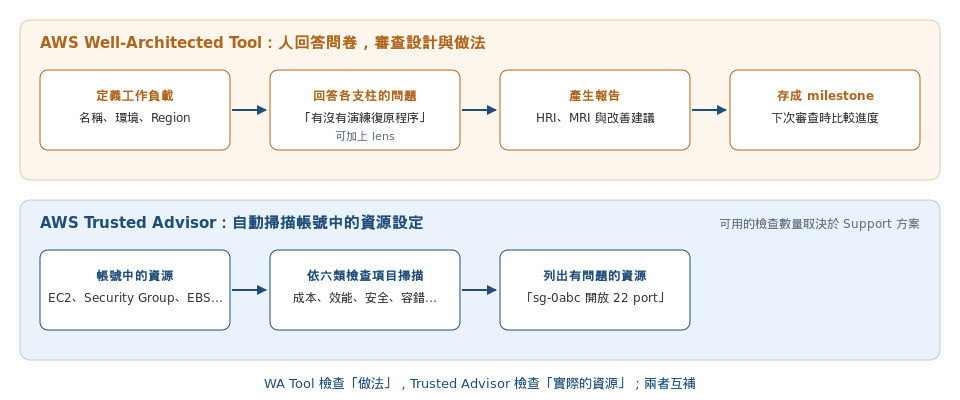
| Well-Architected Tool | Trusted Advisor | |
|---|---|---|
| 檢查什麼 | 架構設計與維運做法 | 帳號中實際存在的資源設定 |
| 怎麼檢查 | 人回答問卷 | 自動掃描 |
| 例子 | 「有沒有定期演練復原程序」 | 「這個 Security Group 對 0.0.0.0/0 開放 22 port」 |
摘要:選項通常都能運作。先刪掉做不到的與違反題目條件的,再用限定詞對應的支柱比較剩下的選項。
某公司在 AWS 上執行 12 個工作負載,分別由不同團隊負責。架構團隊每半年要審查每個工作負載的設計與維運做法,例如是否定期演練復原程序、發生安全事件時如何調查。除了 AWS 的最佳實務,公司另有一套自訂的架構規範,例如新系統上線前必須通過資安團隊的設計審查,也要在同一次審查中一併檢查,並能和上一次的結果比較。
哪一個方案的維運負擔最低(LEAST operational overhead)?
某新創公司的 AWS 帳號使用 Basic Support 方案。安全長要求每天自動取得三類檢查結果並匯入公司內部的儀表板:使用率低的 EC2、閒置的 load balancer,以及 Security Group 對所有 IP 開放特定 port。工程師在 Trusted Advisor 主控台中發現,這些檢查項目大多顯示為無法使用。
哪一個方案能以最低的成本滿足這項需求?
某公司為內部的訂單系統建立開發環境,資料庫使用 Amazon RDS for PostgreSQL,正式環境已經是 Multi-AZ。開發環境只有工程師在平日上班時間使用,夜間與週末都沒有人存取;發生故障時可以接受數小時的停機,但需要能還原到最近 7 天內的任一時間點,以便重現與除錯。
哪一個方案最符合成本效益(MOST cost-effective)?
某公司在 3 個 Region 部署相同的網站環境,包括 VPC、ALB、Auto Scaling group 與 IAM role。目前由工程師依照文件在主控台逐一建立,各 Region 的設定常有細微差異,曾因此在 failover 後網站無法正常運作。公司要求各 Region 的環境完全一致,之後每次變更也要能事先審查,並套用到所有 Region。
哪一個方案的維運負擔最低?
某公司的網站部署在單一 AZ 的一台 m5.4xlarge EC2 上,網站不保存使用者狀態。為了應付每年兩次的促銷活動,這台 instance 的規格是依過去的尖峰流量挑選的,平常的 CPU 使用率不到 10%。去年這台 instance 所在的 AZ 發生故障,網站停擺了 3 小時。
哪一個方案能提供最高的可用性(highest availability),而且不必再依尖峰預先準備容量?
Well-Architected Tool 依各支柱的問題審查工作負載的設計與維運做法,「是否演練復原程序」這類做法上的問題,只能用問卷的方式檢查。公司自訂的規範可以寫成 custom lens:以 JSON 定義自己的問題與最佳實務,發布後和 AWS 的 lens 一起套用到工作負載,同一次審查就能涵蓋兩者;每次審查後存成 milestone,就能和上一次比較。
A 和 C 都以 Config 的 custom rules 表達公司規範,但 Config 只能評估資源的設定,回答不了「是否演練復原程序」「上線前是否通過設計審查」這類做法上的問題;A 的 Trusted Advisor 同樣只檢查資源。D 的方向對了一半:AWS 的最佳實務用 WA Tool 審查,公司規範卻另外用試算表處理,要人工彙整與比較,維運負擔高於把規範做成 custom lens。
Trusted Advisor 的全部檢查與 AWS Support API 都需要 Business Support+ 以上的方案;Basic 方案只有 service limits 類別的全部檢查,以及 security、fault tolerance 類別中的部分檢查。升級到 Business Support+,再以 Lambda 每天呼叫 Support API 取得結果,是滿足需求的方案中費用最低的。
A 是常見的誤解:Support API 不是每個方案都能使用,Basic 方案呼叫時會收到 SubscriptionRequiredException,而且就算拿得到,Basic 方案也沒有使用率低的 EC2 這類成本檢查。B 能做到,但 Enterprise Support 的費用遠高於 Business Support+,在成本的比較中輸了。D 的 Inspector 掃描的是 EC2 的軟體漏洞與網路暴露,不會指出使用率低的 EC2 或閒置的 load balancer,解的是另一個問題。
開發環境可以接受數小時的停機,Single-AZ 就夠了;保留 7 天的自動備份,就能做 point-in-time restore 到 7 天內的任一時間點。夜間與週末沒有人使用,以 EventBridge Scheduler 在下班後停止、上班前啟動 instance,停止期間不收 instance 的費用,只收儲存與備份的費用。RDS 停止期間仍會保留交易日誌,不影響 point-in-time restore;一次最多停止 7 天,週末停止兩天多不會碰到這個限制。
B 能滿足所有要求,但 instance 在沒有人使用的夜間與週末仍然計費,在成本的比較中輸給 A。C 是誤解:read replica 是持續同步的副本,只有「現在」的資料,誤刪的資料也會同步過去,無法回到 7 天內的某個時間點,還多付一個 instance 的費用。D 少了關鍵的一步:每天一份手動 snapshot 只能還原到 snapshot 建立的那一刻,無法還原到任一時間點,不符合除錯的需求。
把環境寫成 CloudFormation 範本,就是以程式碼執行維運:同一份範本建立的環境完全一致,範本放進版本控制後,每次變更都能先審查差異再部署。StackSets 以一次操作把同一份範本部署到多個 Region(也能跨帳號),之後的更新也會套用到所有 Region。
A 只處理了 EC2,網路與權限仍然手動建立,設定差異的根源還在。B 能發現差異,但修正仍靠人工,下一次變更還是可能出錯。C 已經自動化,但每個 Region 一份 runbook,三份要各自維護並依序執行,維運負擔高於一份範本部署到所有 Region。
跨 3 個 AZ 的 Auto Scaling group 掛在 ALB 後方,任何一個 AZ 故障,其他 AZ 的 instance 仍然繼續服務,Auto Scaling 也會補上新的 instance。target tracking policy 依 CPU 使用率自動增減數量:平常只跑少量 instance,促銷時再擴展,不必依尖峰預先準備容量。網站不保存使用者狀態,所以可以直接水平擴展。
A 是垂直擴展,仍然是單一 instance、單一 AZ;recover 只處理底層硬體故障,整個 AZ 故障時無法恢復,規格也還是依尖峰挑選。B 的兩台 instance 在同一個 AZ,AZ 故障時一起停擺;cross-zone load balancing 只是讓流量跨 AZ 平均分配,兩台都在同一個 AZ 時沒有作用。D 能撐過 AZ 故障,但 standby 平常閒置、規格依尖峰準備,切換也受 DNS 快取影響,可用性與容量規劃都不如跨 AZ 的 Auto Scaling group。


 iThome鐵人賽
 看影片追技術